Mostrando entradas con la etiqueta Redes de Telecomunicaciones. Mostrar todas las entradas

viernes, 24 de mayo de 2013

Clase de Redes de Telecomunicaciones, Última tarea

Para la última tarea de la clase de Redes de Telecomunicaciones se nos encargó hacer un resumen sobre un artículo de Redes Sensoras. El artículo que escogí es algo breve pero bien completo.
__________________________________________________________________________

Artículo:
Towards Vehicular Sensor Networks in Android Smartphones for Road Surface

Autores:
Girts Strazdins, Artis Mednis, Georgijs Kanonirs, Reinholds Zviedris, Leo Selavo.

INTRODUCCIÓN
Aunque existen mapas de baches, la recolección de información es manual y basada en reportes individuales. El enfoque manual tiende a ser irregular, y por ello de confianza limitada. Soluciones automatizadas han sido demostradas pero requieren hardware especializado.

Recientemente, ha emergido un enfoque prometedor, llamado "Detección Participativa", usando smartphones - una clase de hardware de "Detección Participativa" virtualmente ubicua y poderosa.

Aunque ya existen sistemas de monitoreo de una superficie participativa , esta es la primera evaluación en plataformas Android, con acelerómetros integrados, sin requerir módulos sensores externos.

Android es una de las plataformas de smartphone más populares, más abiertas y flexibles proveyendo a los desarrolladores de software fácil accesso a hardware de teléfono y API´s ricas en software. La visión de los autores son smartphones Android como una plataforma de detección participativa poderosa y ampliamente usada en un futuro cercano. En este artículo se examinan los smartphones Android en el contexto del monitoreo de la calidad de superficie de carretera.

Se evalúan un conjunto de algoritmos de detección de baches en teléfonos Android con aplicación sensora mientras se conducía un auto en un ambiente urbano. El resultado dió una primera vista en las diferencias de hardware entre varios modelos de smartphone y sugerencias para próximas investigaciones, para la optimización de los algoritmos, para opciones de sensores y para procesamiento de señal.

2. EL ENFOQUE
El enfoque requiere un smartphone Android con GPS, acelerómetro de 3 ejes y un canal de comunicación (Celular o Wifi). El sistema consiste de dos aplicaciones: una para el dispositivo Android y otra para el servidor de datos (siguiente figura).


La aplicación del dispositivo Android tiene una arquitectura impulsada por eventos. Los más importantes son los eventos sensores de disponibilidad de datos, de disponibilidad de conexión a Internet y de Interfaz de usuario. La lista de los sensores usados incluye GPS para detectar la ubicación actual y el acelerómetro para detecta baches. Después de que los datos del sensor son recibidos, estos son procesados y almacenados en la base de datos la cual es periódicamente sincronizada con el servidor principal de la base de datos de manera que ambos tengan información actualizada. La visión es un sistema de detección de baches como un servicio background en el futuro, usado por otras aplicaciones, así que no se pone fuerte énfasis en la interfaz de usuario por el momento.

La aplicación del servidor en la PC es una aplicación web Java con una base de datos SQL basada en el framework Spring. Consiste de un servlet, controlador de datos de sensor y una interfaz de usuario. Se utiliza la API de Google Maps para la visualización de baches.

3. EVALUACIÓN
La evaluación de la solución propuesta fue llevada a cabo en dos experimentos del mundo real en la carretera. Cada vez con un vehículo diferente. Aunque se llevaron a cabo más tests, se descubrió que en ciertas condiciones de clima de invierno la superficie de la carretera podía cambiar en un periodo corto de tiempo, y también que es difícil establecer una realidad del terreno y repetidas corridas del experimento en la misma pista con condiciones consistentemente iguales.

Se llevaron a cabo experimentos en una pista de prueba idéntica a una usada durante previas actividades pero esta vez cada experimento consistió de sólo tres vueltas. Esto debió ser suficiente para obtener una impresión de prueba de concepto sobre los eventos observados y los datos grabados. El equipo para la adquisición de los datos consistió de tres teléfonos celulares Android con la aplicación de recolección de data descrita arriba.

La primera meta fue comparar los datos, los cuales fueron grabados usando equipo diferente, durante el mismo periodo de tiempo. Tal como uno podría esperar, se encontró que las diferentes unidades de hardware con el mismo software tienen diferente tasa de adquisición de datos del acelerómetro y precisión GPS y estabilidad de señal. Este aspecto debe ser considerado en contexto de la posición de granularidad detectada del evento.

Después de la adquisición del primer conjunto de datos se comenzó con algoritmos de detección de eventos empíricos. Se evaluaron los siguientes algoritmos:

- STDEV(Z) - los eventos son detectados por umbralización de la desviación estandar de la aceleración de el eje Z.

- Z-DIFF - se umbralizan diferencias de dos muestras consecutivas del eje Z. Altamente sensible al ruido.

- Z-THRESH - umbralizar el valor absoluto de la aceleración en el eje Z. El enfoque más simple.

- G-ZERO - detecta eventos teniendo el valor del eje Z cercano a cero g. Además de baches y golpes también detecta curvas/vueltas, lo cual tiene que ser filtrado por métodos adicionales.

Cuando se comparan los eventos detectados por medio de métodos utilizados en un trabajo previo (donde se llevó a cabo la umbralización de señal de audio por amplitud) y los eventos detectados por la aplicación sensora en smartphones Android (mostrado en la figura de abajo), ambas parecen compartir tendencias en común. Sin embargo, se requiere un estudio más profundo e información de pruebas adicional para adquirir una precisión de algoritmo y estabilidad de evaluaciones válidos.


4. CONCLUSIONES Y TRABAJO FUTURO
En este artículo se describieron los resultados preliminares de dos pruebas con tres smartphones Android corriendo una aplicación de detección de baches, basada en el procesamiento de información de acelerómetro. A pesar de las diferencias de hardware en términos de precisión de GPS y el muestro de ruido y tasa de muestreo del acelerómetro, se postula que la detección de baches es posible. Sin embargo, para asegurar la hipotesis, es necesaria investigación más a fondo, se debe investigar la combinación de múltiples algoritmos y se debe recolectar un conjunto de datos mas grande y más representativo.

5. CONCLUSIÓN PERSONAL
Antes de leer este artículo yo no sabía que ya había en funcionamiento este tipo de aplicaciones. Me fascinó el hecho de que solo fuera necesario un celular con acelerómetro y GPS para llevar a cabo esto.

Creo que para nuestra ciudad este tipo de aplicaciones serían muy útiles y deberían aumentar en algún momento, especialmente para ser usadas en temporadas de lluvias cuando en unos minutos de lluvia aparecen baches nuevos que el conductor no se esperaba.

Pienso que este tipo de aplicaciones, además de evitar la molestia del conductor de caer en un bache, ayudarían a un mejor flujo del tráfico en calles donde los autos deben ir muy lentos por ir sacándole la vuelta a muchos baches.


Referencia:
Girts Strazdins, Artis Mednis, Georgijs Kanonirs, Reinholds Zviedris, Leo Selavo, "Towards Vehicular Sensor Networks in Android Smartphones for Road Surface"; Institute of Electronics and Computer Science; Faculty of Computing, University of Latvia

[Fecha de acceso: 24 de Mayo de 2013]
Se puede encontrar en: http://strazdins.lv/papers/strazdins2011androidpotholes.pdf

martes, 21 de mayo de 2013

Simulación de red AD-HOC

Para esta semana tuvimos la tarea de simular una red ad-hoc en base a ciertos criterios:

+1 nodos que llegan en intervalos ~ Exp(lambda)
+1 que forman conexiones dentro de un radio de alcance ajustable
+1 que se mueven o de una manera más sofisticada o de dos o más simples
+1 que mandan mensajes por inundación (pueden ser de tamaño fijo)
+1 que cuestan batería según la distancia (y si no son de tamaño fijo, de eso)
+1 provocados por algún fenómeno presente en la zona simulada
+1 usando un valor de TTL
+1 que se adapte durante la simulación según una medida de desempeño
+1 con los nodos muriéndose al acabarse la batería
+1 en una visualización de lo que ocurre


Decidí simular una red de aviones comunicandose entre sí que funciona de la siguiente manera:

- el nodo padre sería la torre de control, y los aviones serían los nodos hijos.
- el intruso sería una tormenta que se acerque a la ruta de alguno de los aviones
- los aviones se pueden comunicar entre si cuando una tormenta se acerca, para que se desvíen en caso de ser necesario.
- Cada avión tiene un radio de comunicación. Para que un avión A pueda enviar un mensaje a un avión B, B tiene que estar dentro del radio de comunicación del avión A.
- De la misma manera, la torre cuenta con un rango de comunicación (mayor al de los aviones). Un mensaje enviado por la torre tiene mayor tiempo de vida.

- los mensajes entre aviones tienen tiempo de vida, donde se termina su vida al haberse enviado 2 veces
- Dependiendo la distancia los mensajes consumirán cierta energía. A mayor distancia, mayor energía se necesita.
- Si  el avión se encuentra dentro de una tormenta se necesitará mayor energía para enviar un mensaje.

La simulación de esta red se muestra de la siguiente manera:


Donde el avión con círculo Verde es el intruso, y el resto, con círculos azules, son los aviones de la red.   La del centro, por si no es obvio, es la torre.

Para calcular si un avión estaba dentro del radio de comunicación de otro avión quise usar el cuadrado circunstricto en las circunferencias.

Lo anterior fue calculado de la siguiente manera:

- Si trazamos el radio de la circunferencia 2 veces hacia dos puntos de la circunfrencia con un ángulo de 90 grados entre ellos, se formará un triangulo (los radios serán los catetos).
- en base a esto, calculamos la hipotenusa de dicho triángulo, lo cual será el largo del lado del cuadrado circunstrito

Aquí el resultado de realizar este calculo:


esto fue donde pude llegar. Mi código es el siguiente:
--

--

martes, 14 de mayo de 2013

Geolocalizacion

Para la tarea de esta semana se nos encargó simular un método de geolocalización. Yo elegí hacer el método de trilateración.

Este es un método muy simple. Conociendo la ubicación de tres puntos (simuladamente estos puntos son antenas) podemos calcular la ubicación de un cuarto punto (un móvil por ejemplo).


Basta con calcular las distancias entre cada "antena" y el "móvil" y dibujar circunferencias en cada antena, donde el radio será esa distancia entre antena y movil. (En realidad dicha distancia es la fuerza de señal de las antenas, con las que calcularemos la ubicación del punto que queremos conocer).

La explicación exacta del código en donde yo me basé está en esta página.

El codigo es el siguiente:


Referencias:
TULIP Algorithm Alternative Trilateration Method, 2012, LesCottrell https://confluence.slac.stanford.edu/display/IEPM/TULIP+Algorithm+Alternative+Trilateration+Method

martes, 30 de abril de 2013

Control de Congestion

Para esta entrada se nos encargó simular control de congestion en ns-2.

Para lograr esto, se reciclaron conocimientos de tareas anteriores para crear las topologías y para simular el tráfico. Ahora lo nuevo fue integrar una fórmula para calcular el ancho de banda de la red. En base a este ancho de banda conocido, decidimos si aumentamos o disminuimos la cantidad de paquetes que se envían.

Las fórmulas usadas en el código, y cómo graficar en xgraph se encontró en este enlace.

El código:

//
//

El resultado:

La línea verde muestra que la cantidad de paquetes perdidos es poca, esto debido a la poca congestión de la red.

Referencias:
Tutorial de xgraph: http://www.isi.edu/nsnam/ns/tutorial/

martes, 26 de febrero de 2013

Puntos extra: Network Simulator NS2

MODELADO DE LATENCIA Y ENTREGA DE PAQUETES EN SISTEMAS DE CONTROL DE RED USANDO EL SIMULADOR DE RED NS2

1. Introducción:
Los sistemas de control de red (NCS - Network Control Systems) implementan un mecanismo de control de lazo cerrado a través de una red. Recientemente se le está prestando atención a los sistemas de control de red inalámbricos (WNCS - Wireless Network Control Systems). Los WNCS son flexibles y robustos por lo tanto son apropiadas para diversas aplicaciones. Estas redes permiten que sistemas de control sean usados de manera remota como por ejemplo llevar a cabo una tele-cirugía.

La estructura distribuida básica de una WNCS es la siguiente:


el estado de la planta es captado por los sensores y mandado al controlador a través de la red inalámbrica. El controlador compara el estado con un modelo de referencia y calcula las señales de control adecuadas. Después la señal de control es enviada al actuador a través de la red inalámbrica para ser implementada en la planta. 

2. Problemas de diseño de red para los Sistemas de Control de Red (NCS).

Una red debe cumplir las siguientes limitaciones:
  • Paquetes frecuentes pequeños 
  • Retardo de paquetes limitado (entre menor el retardo mejor el desempeño).
  • Entrega de paquetes de calidad.
Los retardos y la falla al entregar paquetes pueden degradar el desempeño del NCS, por ello son los dos aspectos más importantes a tratar en el diseño de red para los NCS.

3. El modelo para la simulación
Se ha escogido un tanque de agua simple como la planta de menare que el retardo del controlador puede ser ignorado. El peso actual del agua es enviado al controlador. El controlador envía el flujo de entrada controlado al tanque, el cual está inicialmente vacío. El flujo de entrada es arreglado de acuerdo a la diferencia del peso del tanque y el peso deseado.

El modelo mencionado se muestra aquí : 


4. Resultados

Cuando usamos el NS2 para un modelo como este, la simulación nos arroja los siguientes archivos, para el propósito de análisis.


  • Archivo de rastreo: información detallada del paquete.
  • Archivo Nam: para ejecutar animaciones de la WNCS
  • Archivo de salida Plant: tiempo contra peso del agua.
Para información más extensa sobre este tema, puedes leer este documento PDF. 


Referencia:
http://link.springer.com/article/10.1007%2Fs11633-005-0187-x?LI=true

TAREA 4: CALIDAD DE SERVICIO

En mi entrada de laboratorio mencioné que iba a medir la calidad de servicio para la página http://www.seriales.us/ .

Por medio de la terminal podemos hacer ping a una página y al mismo tiempo recibir un archivo .dat para recibir los datos.

ping -c n -direccion- >> - nombre del archivo.DAT -  

donde n es la cantidad de pings que voy a recibir -direccion-  es el nombre de la página a la que le haremos ping, y nombre del archivo  es cómo quieres llamar al archivo .dat donde recibirás los datos.

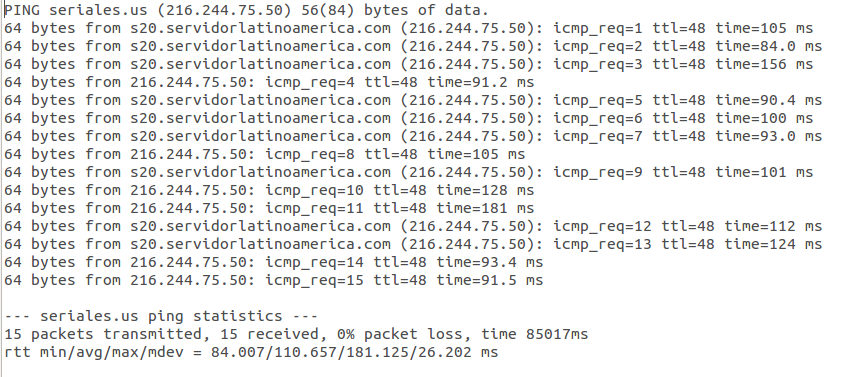
El resultado es el siguiente: 


LATENCIA
En los resultados que nos lanzó este comando, podemos ver el retardo de cada paquete:


La variable time que vemos aquí es el tiempo que tomó cada paquete en llegar, o sea el Retardo/Latencia.

martes, 19 de febrero de 2013

TAREA 3: ATAQUE ARP SPOOFING

Para esta ocasión teníamos la tarea de realizar un tipo de ataque a redes wifi. Mi elección fue el ARP Spoofing. Este ataque nos permite leer paquetes de datos, modificar o hasta detener el tráfico en una red LAN.

Para ello utilice el programa Ettercap.

En ubuntu el comando para instalarlo es el siguiente:


Para iniciarlo es así:


Con este programa el ataque es bastante simple. Seleccionas la opción Sniff > Unified Sniffing, y le pasas la interface de red mediante la que se va a realizar el ataque :


Despues de que nos lanza cierta información , escanearemos hosts dentro de nuestra red con la opcion Hosts > Scan Hosts


Para ver la lista de host disponibles para el ataque, elegimos Hosts > Hosts List, de donde podremos añadir nuestros objetivos eligiendo el host que queremos atacar y clickeando en ADD TO TARGET ...


Y para realizar el ataque a los hosts elegidos, simplemente elegimos: Mitm > Air poisoning y despues Start > Start Sniffing


Y listo, con eso es suficiente recibas los paquetes que están siendo transmitidos en los hosts dados.


Referencias:
http://es.wikipedia.org/wiki/ARP_Spoofing
Tutorial de Ettercap

martes, 12 de febrero de 2013

TAREA 2: IMPLEMENTACIÓN DE UN PROTOCOLO

Para esta entrada toca implementar un protocolo, para el cual usaremos la comunicación UDP (User Datagram Protocol).

¿Qué es el UDP?
El UDP es un protocolo NO orientado a conexiones, es decir que cuando dos maquinas intentan comunicarse, no es necesario que el servidor confirme la conexión, simplemente manda el paquete al cliente destino que lo requiere.

Cuando se envía un paquete de información, el UDP envía un solo stream de información, a diferencia del TCP que envía los paquetes por partes.
   
En este vídeo hay una muy buena explicación simple y rápida de lo que hace el UDP, y de paso, lo que también hace el  protocolo TCP.


Para mi tarea, estaba intentando implementar un chat, pues me llama la atención cómo funcionan las conversaciones múltiples de facebook . No lo logré completar , el código siguiente muestra solo una conexión broadcast implementada en python.

Aquí está el código. Ambos del cliente y servidor, están implementados en un solo archivo UDP.py, donde para correrlo ingresas como parámetro la palabra cliente o la palabra servidor:

python UDP.py servidor
python UDP.py cliente

Aquí están 2 clientes mandando un mensaje al servidor:


Link para el codigo:
https://gist.github.com/Esteban-Sifuentes/4773076

martes, 5 de febrero de 2013

TAREA 1 : RFC 4302 - CABECERA DE AUTENTICACION IP


Introducción
La cabecera de autenticación IP  es usado para proveer integridad sin conexión y autenticación del origen de información para datagramas IP, y para proveer protección contra 'replays'.

La cabecera de autenticación provee tanta protección a la cabecera del IP como sea posible, sin embargo algunos campos de la cabecera IP pueden cambiar durante el transito además, cuando el paquete llega al receptor, el valor de dichos campos puede ser impredecible para el emisor. El valor de dichos campos no pueden ser protegidos por la cabecera de autenticación. Por lo tanto, la protección que la cabecera de autenticación brinda a la cabecera IP es sistemática.

Formato de la cabecera de autenticación 
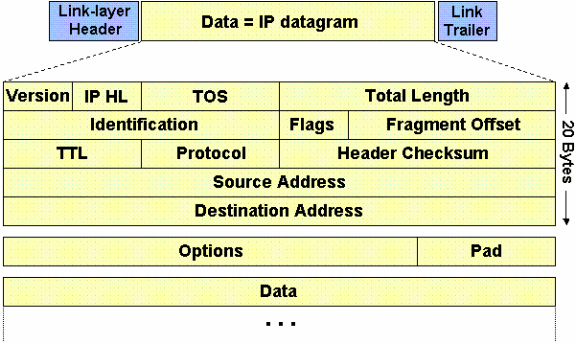
El protocolo de la cabecera IP que precede inmediatamente la cabecera de autenticación debe contener el valor 51 en sus campos 'Protocol' o en 'Next Header' (IPv4 , IPv6, respectivamente), como se muestra a continuación: 


Los campos que comprende la cabecera de autenticación se muestran a continuación (en base al formato mostrado arriba) y qué se transmite en cada uno de ellos:


# of bytes What is
transmitted
IP Header
variable
Plain
Next Header 
1
Plain
Payload Len
1
Plain
RESERVED
2
Plain
SPI
4
Plain
Seq # (low-order 32 bits) 
4
Plain
ICV
variable
Plain
IP datagram 
variable
Plain
Seq # (low-order 32 bits)
4
  Not transmitted  
ICV Padding
variable
  Not transmitted  

Ahora se definirán los campos que comprenden al formato de cabecera de autenticación:

a) Next Header
Campo de 8-bits que identifica el tipo del siguiente payload después de la cabecera de autenticación, cuyo valor es elegido de un grupo de protocolos IP de la IANA (http://www.iana.org/). Por ejemplo, el valor 4 indica IPv4.

b) Payload Lenght
Campo de 8-bits que especifica la longitud de la cabecera de autenticación en palabras de 32 bits.

c) Reserved
Cambo de 16-bit reservado para uso futuro. Se debe inicializar en 'cero' por el emisor , y debe ser ignorado por el receptor.

d) Security Parameters Index (SPI)
Valor arbitrario de 32-bits usado por el receptor para identificar el SA al cual está unido un paquete entrante. Este campo es obligatorio.

e) Número de Secuencia
Campo de 32-bits sin signo que contiene un contador que incrementa en uno por cada paquete enviado. La cabecera de autenticación no provee medios para sincronizar contadores de paquetes entre multiples enviadores. Este campo es obligatorio , el emisor siempre debe transmitirlo , pero el receptor debe actuar en base a ello.

f) Valor de comprobación de integridad
Campo de longitud variable que contiene el valor de comprobación de identidad de un paquete. El campo debe ser un entero múltiplo de 32 bits en longitud. Este campo puede incluir 'relleno' explícito, si se requiere asegurar que la longitud de la cabecera de autenticación es de 32 bits o 64 bits (IPv4 , IPv6 respectivamente)

f) Auditoría
No todos los sistemas que implementen la cabecera de autenticación implementan auditoría. Sin embargo, si la cabecera de autenticación esta implementada en sistemas que utilizan auditoría, entonces la implementación de esta cabecera  tambien debe soportar auditoria y debe permitir que un sistema administrador habilitar o deshablitar auditoría.

Esto ha sido a grandes rasgos el formato del formato de cabecera de autenticación IP y la definición breve de los campos que lo conforman. A manera de conclusión personal puedo decir que sin un estandar en las cabeceras IP se crearia una enorme confusión a la hora de la transimisión de los datos ya que al momento de leer cada fracción de los paquetes toda la comunicación podria verse bloqueada o arruinada ya que no se puede saber que se esta transmitiendo en realidad.